HTML
HTML (HyperText Markup Language) est le langage de balisage utilisé pour créer des pages web. Il s'agit d'un élément fondamental dans la création de sites web, car il permet de structurer le contenu d'une page en utilisant des balises. Ces balises définissent la structure et la signification des éléments d'une page, tels que les titres, les paragraphes, les images, les liens, les formulaires, et bien plus encore. La mise en forme visuelle (couleurs, polices, disposition) est confiée à un autre langage, le CSS.
HTML utilise une syntaxe composée de balises (encadrées par des chevrons, comme <balise>) et de contenu (placé entre les balises).
Les balises peuvent également inclure des attributs qui fournissent des informations supplémentaires sur un élément.
Par exemple, la balise <a> (utilisée pour les liens) peut inclure un attribut href qui spécifie l'URL vers laquelle le lien pointe.
Les attributs sont ajoutés sous forme de paires nom-valeur à l'intérieur des balises, avec une syntaxe ressemblant à ceci : nom="valeur".
Les navigateurs web interprètent ensuite le code HTML pour afficher la page web correspondante à l'utilisateur.
Après la déclaration <!doctype html>, une page HTML de base contient la balise <html>, qui englobe l'ensemble du document.
A l'intérieur de cette balise, on trouve les balises <head> pour les métadonnées et les liens vers des fichiers externes, ainsi que la balise <body> pour le contenu visible de la page.
Les balises HTML se divisent en trois catégories : balises ouvrantes, balises fermantes et balises des éléments vides, chacune ayant un rôle spécifique.
- Balises ouvrantes : elles débutent un élément HTML et sont entourées de chevrons, comme
<p>. Elles marquent le début de l'élément et peuvent contenir des attributs. - Balises fermantes : elles marquent la fin d'un élément HTML et ressemblent aux balises ouvrantes, mais incluent un slash avant le nom, comme
</p>. Elles indiquent où se termine l'élément. - Eléments vides (void elements) : ils n'ont pas de contenu et s'écrivent avec une seule balise, sans balise fermante, comme
<img>ou<br>. Ils sont couramment employés pour insérer des médias, des sauts de ligne ou des métadonnées.
Tip
On rencontre aussi la notation avec une barre oblique finale, comme <img />, héritée de XHTML et ajoutée par certains outils de formatage. Elle est acceptée par le standard HTML, mais n'a aucun effet. Dans ce cours, on écrit <img> (voir Code style).
Structure d'une page HTML
<!doctype html>
<html lang="en">
  <head>
    <meta charset="utf-8">
    <title>…</title>
  </head>
  <body>
    …
  </body>
</html>
<!doctype html>
- Le
doctypeest nécessaire pour des raisons historiques. - Lorsqu'il est omis, les navigateurs peuvent utiliser un mode de rendu différent, appelé mode quirks, qui est incompatible avec certaines spécifications modernes.
<html lang="en">
- L'élément
htmlreprésente la racine d'un document HTML. - Il est recommandé de spécifier un attribut
langsur l'élémenthtml, indiquant la langue principale du document. - Cela aide les outils d'accessibilité, comme les synthétiseurs vocaux, à utiliser la bonne prononciation, et les outils de traduction à appliquer les règles linguistiques appropriées.
<head>
- L'élément
headcontient un ensemble de métadonnées pour le document, telles que le titre, les liens vers les feuilles de style et les informations de configuration.
<meta charset="utf-8">
- Les éléments
metafournissent des métadonnées qui ne peuvent pas être exprimées avec les élémentstitle,base,link,styleouscript. - L'attribut
charsetspécifie l'encodage des caractères utilisé par le document :utf-8est la seule valeur autorisée par le standard HTML.
<title>
- L'élément
titlereprésente le titre ou le nom du document, qui apparaît dans l'onglet du navigateur.
<body>
- L'élément
bodycontient tout le contenu visible par les utilisateurs, tel que le texte, les images, les vidéos et les autres éléments interactifs de la page.
Sources :
- WHATWG - HTML Standard (13.1.1 The DOCTYPE)
- WHATWG - HTML Standard (4.2.5.4 Specifying the document's character encoding)
Retour à la ligne
Les retours à la ligne dans le code source HTML ne provoquent pas de saut de ligne dans la page affichée par le navigateur web.
Pour insérer un saut de ligne, il faut utiliser la balise <br> :
<body>
  Some text…
  More text…
  <br>
  The "br" tag creates a line break!
</body>

Espace
Dans le code source HTML, les espaces multiples (c'est-à-dire plusieurs espaces consécutifs) sont réduits à un seul espace lorsqu'ils sont affichés dans le navigateur. Ainsi, même si plusieurs espaces sont présents entre les mots ou les éléments dans le code, ils seront affichés comme un seul espace sur la page web.
<body>
  <p>This     is     an     example</p>
</body>

Catégories de contenu
Les catégories de contenu sont un concept essentiel en développement web, car elles définissent comment les éléments HTML sont structurés et interagissent les uns avec les autres. Chaque élément appartient à une ou plusieurs catégories de contenu. Ces catégories regroupent donc des éléments partageant un ensemble de caractéristiques communes.
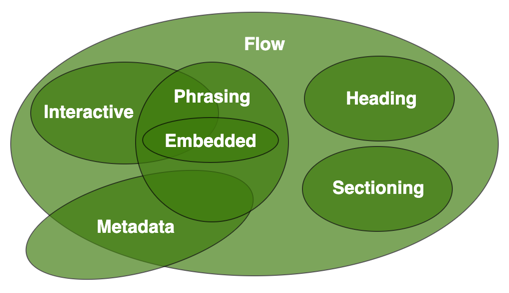
Metadata Content (contenu de métadonnées) : cette catégorie regroupe les informations cruciales sur le document, telles que les données de référencement, les encodages de caractères et les liens vers des feuilles de style et des scripts.
Balises : <base>, <link>, <meta>, <noscript>, <script>, <style>, <template> et <title>
Flow Content (contenu de flux) : les éléments de cette catégorie forment le coeur de la page, comprenant les paragraphes, les titres, les listes, les tableaux, les images et les liens. Ils façonnent la structure générale de la page.
Balises : <a>, <article>, <audio>, <br>, <button>, <div>, <footer>, <h1>, <header>, <img>, <input>, <p>, <ul>, <table>, …
Sectioning Content (contenu de sectionnement) : ces éléments divisent la page en sections sémantiques, facilitant ainsi la compréhension et l'accessibilité du contenu. Ils définissent également la portée des titres et des pieds de page.
Balises : <article>, <aside>, <nav> et <section>
Heading Content (contenu de titre) : les balises de titre déterminent la hiérarchie des titres sur la page, aidant les utilisateurs et les moteurs de recherche à comprendre la structure de l'information.
Balises : <h1>, <h2>, <h3>, <h4>, <h5>, <h6> et <hgroup>
Phrasing Content (contenu phrasé) : cette catégorie comprend le texte du document et les éléments qui le balisent à l'intérieur d'un paragraphe (mise en valeur, liens, images, champs de formulaire, etc.). Une suite de contenu phrasé forme un paragraphe.
Balises : <a>, <b>, <button>, <em>, <i>, <img>, <input>, <label>, <span>, <strong>, <textarea>, <u>, …
Embedded Content (contenu incorporé) : ces éléments permettent d'intégrer des médias et des contenus externes dans une page web, enrichissant l'expérience utilisateur.
Balises : <audio>, <canvas>, <embed>, <iframe>, <img>, <math>, <object>, <picture>, <svg> et <video>
Interactive Content (contenu interactif) : les éléments interactifs permettent aux utilisateurs d'interagir directement avec la page via des formulaires, des boutons cliquables et d'autres éléments.
Balises : <a> (avec href), <audio> et <video> (avec controls), <button>, <details>, <embed>, <iframe>, <img> (avec usemap), <input> (sauf type="hidden"), <label>, <select>, <textarea>, …
Sources :
Tip
Toujours se référer à la spécification HTML
Pour savoir comment utiliser les balises :
- Comment créer des listes imbriquées ?

Pour connaître la sémantique d'une balise :
- Quelle est la différence entre
<b>et<strong>?

Réponses : Listes imbriquées


<ul>
  <li>
    Fruits
    <ul>
      <li>Pommes</li>
      <li>Oranges</li>
      <li>Bananes</li>
    </ul>
  </li>
  <li>
    Légumes
    <ul>
      <li>Carottes</li>
      <li>Tomates</li>
      <li>Brocolis</li>
    </ul>
  </li>
</ul>
Réponses : Différence entre <b> et <strong>


<strong>Attention :</strong> Il est important de lire la documentation !

Le langage HTML est facile à écrire si on lit la <b>documentation</b> !
Références de caractères
Les références de caractères nommées (named character references), couramment appelées « entités HTML », sont des codes utilisés pour représenter des caractères réservés ou spéciaux dans le code HTML.
Ces codes commencent toujours par une esperluette (&), suivie d'un nom, puis se terminent par un point-virgule (;).
Les caractères réservés par la syntaxe HTML doivent être encodés de cette manière pour éviter toute confusion avec les balises.
Note
Dans un fichier encodé en UTF-8, les caractères accentués et les symboles (é, à, €, ©…) s'écrivent directement : inutile d'utiliser é ou €.
Sources :
- WHATWG - HTML Standard (13.1.4 Character references)
- W3C - Using character escapes in markup and CSS
Caractères à toujours encoder
< (inférieur à)
- Le caractère
<est utilisé pour ouvrir les balises HTML. - Si vous souhaitez l'afficher tel quel dans le contenu de votre page, vous devez l'encoder en
<. - Sinon, il serait interprété comme le début d'une balise HTML, ce qui pourrait perturber la structure de la page.
& (esperluette)
- L'esperluette est utilisée pour commencer une référence de caractère en HTML.
- Si vous souhaitez afficher une esperluette telle quelle, vous devez l'encoder en
&. - Sinon, le navigateur interprétera le texte suivant comme une référence HTML, ce qui peut entraîner des erreurs de rendu.
Autres caractères fréquemment encodés
Afin d'éviter divers problèmes d'affichage et de sécurité (notamment sur les sites web dynamiques), certains caractères supplémentaires sont également encodés :
> (supérieur à)
- Ce caractère est utilisé pour fermer les balises HTML.
- Pour afficher un
>tel quel, vous pouvez l'encoder en>.
" (guillemets doubles)
- Les guillemets doubles sont utilisés pour délimiter les valeurs des attributs HTML.
- Pour en placer un dans une valeur d'attribut délimitée par des guillemets doubles, il faut l'encoder en
". Dans le texte de la page, il s'écrit normalement.
' (apostrophe)
- Les apostrophes sont également utilisées pour délimiter les valeurs des attributs HTML.
- Pour en placer une dans une valeur d'attribut délimitée par des apostrophes, il faut l'encoder en
'. Dans le texte de la page, elle s'écrit normalement.
Références de caractères numériques
Chaque caractère Unicode peut être encodé dans le code source HTML grâce aux références de caractères numériques décimales ou hexadécimales.
Il s'agit d'utiliser le code point du caractère Unicode sous la forme &#…; (décimale) ou &#x…; (hexadécimale).
Par exemple, 🥸 peut être encodé avec 🥸 ou 🥸.

Caractères invisibles ou ambigus
Dans certains cas particuliers, il peut être nécessaire d'utiliser des caractères spéciaux invisibles.
Un exemple est le caractère Unicode U+200F Right-To-Left Mark, utilisé pour gérer la direction dans un texte bidirectionnel (par exemple, pour les écritures arabe ou hébraïque).
Cependant, il n'a pas de forme graphique visible, ce qui rend difficile l'identification de sa présence dans le code source.
Comme on ne les voit pas, ces caractères peuvent être supprimés ou déplacés par erreur lors d'une édition ultérieure, avec des résultats inattendus.
Un autre exemple est le caractère Unicode U+00A0 No-Break Space.
Cet espace empêche le retour à la ligne, mais ressemble à un espace ordinaire lorsqu'il est utilisé.
Il peut donc être difficile à identifier dans le code source.
Tip
Dans ce type de cas particuliers, il est fortement recommandé d'utiliser les références de caractères (ex. ‏, ) : elles rendent ces caractères visibles dans le code source.
Source : W3C - Using character escapes in markup and CSS (When escapes can be useful)
Lien utile
Conception d'une page web
- Réfléchir et concevoir la structure d'une page web avant de la coder.
- Aller au-delà du simple affichage dans un navigateur web.
- Utiliser les balises HTML en fonction de leur sémantique.
1. Réfléchir et concevoir
Le processus de conception d'une page web commence par des esquisses pour générer des idées, passe ensuite aux wireframes pour définir la structure, et se termine par les mockups pour créer une représentation visuelle détaillée de la page. Chaque étape joue un rôle crucial dans la création d'une page web fonctionnelle et esthétiquement agréable.
Sketch (esquisse)
- L'esquisse est la première étape du processus de conception.
- Elle consiste à créer des croquis rapides et informels sur papier ou à l'aide d'outils numériques pour explorer des idées initiales.
- A ce stade, l'accent est mis sur la créativité et la génération d'idées.
- Les croquis peuvent inclure la disposition générale de la page, la disposition des éléments clés, la navigation de base et d'autres idées visuelles.
- Cela permet de capturer rapidement les concepts sans se soucier des détails.
Wireframe (maquette fil de fer)
- Après les esquisses, la prochaine étape consiste à créer des wireframes.
- Les wireframes sont des représentations schématiques et structurées de la page web.
- Ils sont généralement en noir et blanc et se concentrent sur la disposition et la hiérarchie des éléments.
- Les wireframes définissent la structure de la page, l'emplacement des éléments, les zones réservées au contenu, la navigation et d'autres éléments clés.
- Ils aident à planifier la convivialité et la fonctionnalité de la page sans se soucier des aspects visuels détaillés.
Mockup (maquette graphique)
- Une fois la structure de base définie à l'aide des wireframes, on passe à la création de maquettes graphiques.
- Les mockups sont des représentations visuelles de la page web avec des détails graphiques tels que les couleurs, les polices, les images et les éléments de design.
- Les maquettes graphiques donnent vie à la conception en montrant à quoi ressemblera la page web une fois terminée.
- Elles servent également de référence pour le développement, car elles fournissent des indications précises sur l'apparence visuelle de la page.


2. Penser plus loin
Moteurs de recherche
L'optimisation pour les moteurs de recherche (SEO) est un aspect essentiel de la conception de pages web. Pour garantir que votre site soit bien classé dans les résultats de recherche et atteigne un public plus large, il est crucial de prendre en compte plusieurs éléments :
- Choix des mots-clés : utiliser des mots-clés pertinents pour le contenu de la page.
- Titre de la page (
<title>) : s'assurer que le titre de chaque page est unique, descriptif, concis et contient un ou plusieurs mots-clés pertinents. Un titre trop long est tronqué dans les résultats de recherche. - URL conviviale : créer des URL lisibles par l'humain, avec des mots séparés par des traits d'union (
-). Eviter les URL longues et complexes contenant des numéros d'identification ou de nombreux paramètres. - Balises de titre (
<h1>à<h6>) : utiliser les balises de titre pour structurer le contenu. L'élément<h1>devrait contenir le titre principal de la page, et les autres balises de titre devraient organiser le contenu de manière logique. - Contenu de qualité : rédiger un contenu informatif, pertinent et de haute qualité, qui répond aux besoins des utilisateurs.
- Balises sémantiques : utiliser les balises HTML sémantiques (
<article>,<section>,<header>,<footer>, etc.) pour structurer le contenu de manière claire et significative. - Optimisation des images : utiliser l'attribut
altpour décrire les images de manière concise et pertinente. - Liens internes et externes : créer des liens internes vers d'autres pages du site pour améliorer la navigation, et inclure des liens vers des sources externes de confiance lorsque cela est pertinent.
- Description de la page (
<meta name="description">) : rédiger pour chaque page un résumé unique et descriptif, que le moteur de recherche peut afficher sous le titre. La balise<meta name="keywords">(liste de mots-clés) est ignorée par Google. - …
Sources :
- Google Search Central - Influencing your title links in search results
- Google Search Central - URL structure best practices for Google Search
- Google Search Central - Meta tags and attributes that Google supports

Agrégation de contenus
L'agrégation de contenus, en informatique et dans le contexte du développement web, fait référence à la collecte, la fusion et la présentation de contenus provenant de différentes sources ou sites web sur une seule plateforme. Elle permet de regrouper des informations issues de diverses sources pour offrir aux utilisateurs une expérience de navigation centralisée.
Par exemple, un agrégateur de nouvelles en ligne peut rassembler des articles de plusieurs médias et les présenter sur une seule page, permettant ainsi aux utilisateurs de consulter différentes perspectives en un seul endroit.
La création d'un site web destiné à être agrégé par d'autres services nécessite une attention particulière aux aspects techniques du code HTML. Un code bien structuré et conforme aux normes permet aux agrégateurs d'extraire facilement et avec précision votre contenu.
Les points techniques mentionnés pour les moteurs de recherche s'appliquent également afin que vos contenus puissent être exploités efficacement par les agrégateurs.


Lecteur d'écran et synthèse vocale
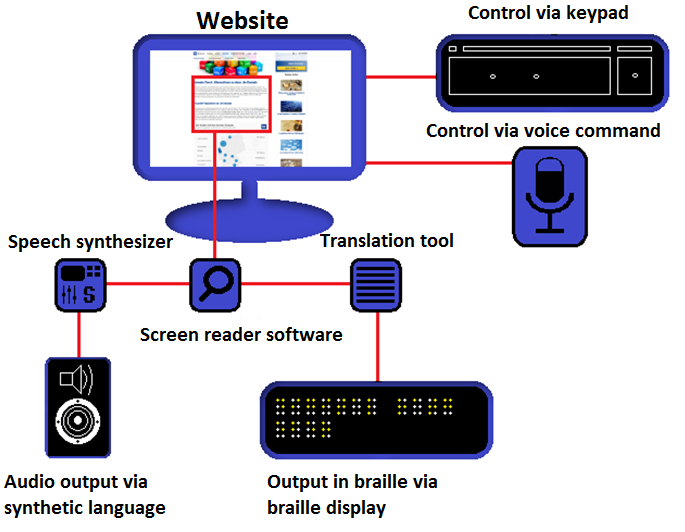
La conception de pages web accessibles aux lecteurs d'écran et à la synthèse vocale est essentielle pour garantir l'accessibilité des personnes aveugles ou malvoyantes.
- Structuration sémantique : utiliser les balises HTML appropriées (
<header>,<nav>,<main>,<footer>, etc.) pour structurer le contenu de manière claire. Cela aide les lecteurs d'écran à comprendre la hiérarchie et la signification du contenu. - Texte alternatif pour les images : chaque image doit avoir un attribut
altdescriptif expliquant son contenu. Les lecteurs d'écran utilisent ces descriptions pour informer l'utilisateur. - Ordre de lecture : assurer un ordre logique et cohérent, même si la mise en page visuelle est différente. Les lecteurs d'écran suivent généralement l'ordre du code HTML.
- Contraste : le texte et les éléments interactifs doivent avoir un contraste suffisant par rapport à l'arrière-plan pour faciliter la lecture.
- Eviter les éléments non textuels : ne pas créer d'éléments interactifs qui ne sont que des images sans texte explicite, car cela rendrait la compréhension difficile pour les utilisateurs de lecteurs d'écran.
- ARIA : utiliser les attributs ARIA (Accessible Rich Internet Applications) lorsque cela est nécessaire pour améliorer l'accessibilité des éléments interactifs complexes, tels que les menus déroulants. Si un élément HTML existe déjà pour l'usage voulu (
<button>,<nav>,<select>…), l'utiliser plutôt qu'ARIA.
Note
WAI-ARIA (Accessible Rich Internet Applications), souvent abrégé ARIA, est une norme du W3C (version 1.2, recommandation de juin 2023). Elle définit des rôles et des attributs à ajouter au HTML pour décrire aux outils d'assistance ce que fait un composant de la page, lorsque le HTML seul ne suffit pas.
Exemples d'usage : un menu ou un onglet construit en JavaScript, un message d'erreur de formulaire, une zone de la page mise à jour sans rechargement.
Première règle d'ARIA : si un élément HTML natif offre déjà le sens et le comportement voulus, l'utiliser plutôt que d'ajouter des attributs ARIA.
Sources :

Chatbots et agents IA
Les assistants conversationnels (chatbots) comme ChatGPT, Claude ou Gemini, ainsi que les réponses générées par IA dans les moteurs de recherche (ex. AI Overviews de Google), citent de plus en plus de pages web comme sources. Les agents IA vont plus loin : ce sont des programmes qui naviguent sur un site à la place de l'utilisateur pour accomplir une tâche (comparer des produits, remplir un formulaire, réserver une table).
Comment un chatbot choisit-il les liens qu'il recommande ?
- Ce que le modèle a appris pendant son entraînement ne contient pas de liens fiables : il peut se tromper d'adresse, voire en inventer une.
- Pour citer une page, le chatbot effectue une recherche web : il interroge un moteur de recherche, lit quelques-unes des pages trouvées, puis rédige sa réponse avec des liens vers ces pages. Google lance même plusieurs recherches liées en parallèle sur des sous-thèmes de la question (query fan-out).
- Les critères exacts de sélection des pages ne sont pas publiés.
→ Une page bien référencée et accessible aux robots a plus de chances d'être citée.
Points essentiels :
- Pas de recette spéciale : selon Google, il n'est pas nécessaire de créer un fichier dédié à l'IA, de découper le contenu en petits morceaux ni de le réécrire « pour l'IA ». Les bonnes pratiques SEO présentées ci-dessus restent la base.
- Contenu présent dans le HTML : contrairement à Google, plusieurs robots d'IA (ex. ceux d'OpenAI, d'Anthropic et de Perplexity) téléchargent les fichiers JavaScript sans les exécuter. Un texte affiché uniquement par JavaScript leur reste invisible donc le contenu important doit se trouver dans le HTML envoyé par le serveur.
-
Robots autorisés : un robot d'indexation (crawler) est un programme qui parcourt le web automatiquement pour lire les pages. Le fichier
robots.txt, placé à la racine du site, indique aux robots les pages qu'ils peuvent visiter. Les entreprises d'IA utilisent des robots distincts selon l'usage, par exemple :- OpenAI :
GPTBot(entraînement des modèles) etOAI-SearchBot(recherche dans ChatGPT) ; - Anthropic :
ClaudeBot(entraînement des modèles) etClaude-SearchBot(recherche dans Claude).
Un site peut refuser l'entraînement tout en restant cité : il bloque le robot d'entraînement et autorise le robot de recherche.
- OpenAI :
-
Agents IA : ils analysent une page à partir de captures d'écran, du code HTML et de l'arbre d'accessibilité (la représentation de la page utilisée par les lecteurs d'écran). Ce qui aide un lecteur d'écran aide aussi un agent IA :
<button>et<a>plutôt que des<div>ou des<span>rendus cliquables- Chaque
<label>relié à son champ de formulaire avec l'attributfor - Une mise en page stable, sans calque transparent qui recouvre les éléments interactifs
<!-- Peu clair pour un agent IA et pour un lecteur d'écran -->
<div class="btn" onclick="send()">Envoyer</div>

<!-- Clair : l'élément est un bouton -->
<button type="submit">Envoyer</button>
Sources :
- Google Search Central - Optimizing your website for generative AI features on Google Search
- Google Search Central - AI features and your website
- Vercel - The rise of the AI crawler (décembre 2024)
- OpenAI - Overview of OpenAI Crawlers
- Anthropic - Does Anthropic crawl data from the web, and how can site owners block the crawler?
- web.dev - Build agent-friendly websites
llms.txt : un fichier pour les IA ?
llms.txt est une proposition publiée en septembre 2024 par Jeremy Howard : un fichier Markdown placé à la racine du site, qui résume le site et liste ses pages principales à l'intention des grands modèles de langage (LLM, Large Language Models), les programmes sur lesquels reposent les chatbots.
Ce n'est pas un standard et son utilité reste discutée (octobre 2026) :
- Google Search l'ignore et indique qu'il n'est pas nécessaire.
- Lighthouse, l'outil d'analyse de pages intégré à Chrome, vérifie pourtant sa présence dans une catégorie expérimentale consacrée aux agents IA (Agentic Browsing).
Par ailleurs, l'IETF prépare un vocabulaire standard pour qu'un site puisse exprimer ses préférences d'utilisation par l'IA (groupe de travail AIPREF). Il est encore à l'état de brouillon.
Sources :
3. Structuration sémantique
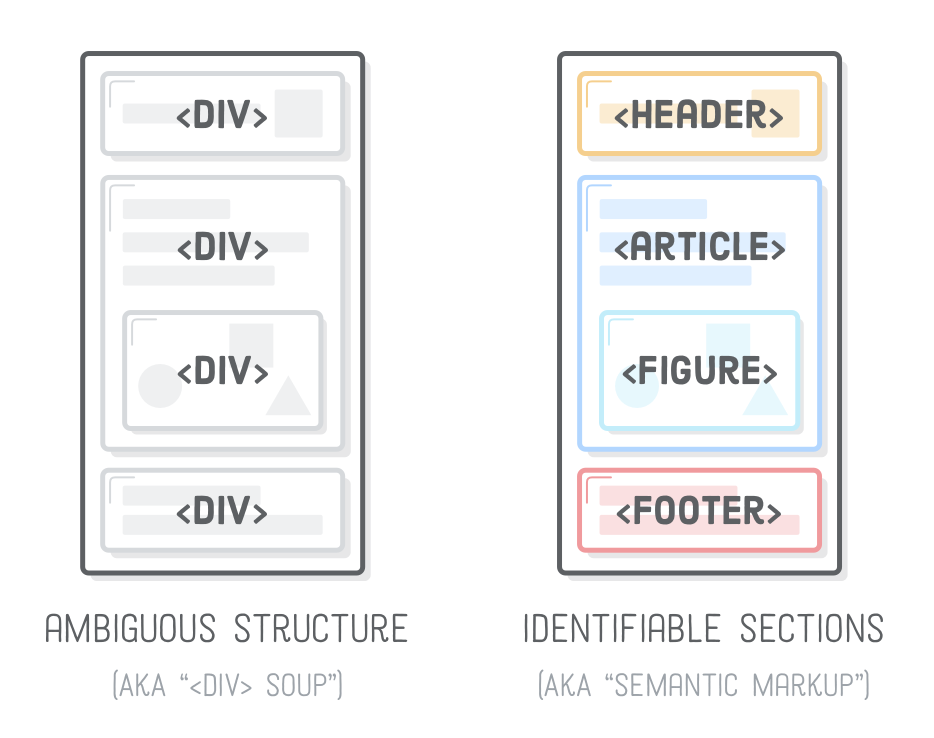
La structuration sémantique d'une page web est un concept essentiel en développement web. Elle consiste à utiliser les balises HTML de manière appropriée pour décrire le contenu de la page de façon significative et structurée. Cela permet, par exemple, aux navigateurs web, aux moteurs de recherche, aux technologies d'assistance et aux agents IA de comprendre la hiérarchie et la signification du contenu de la page.

Article et Section
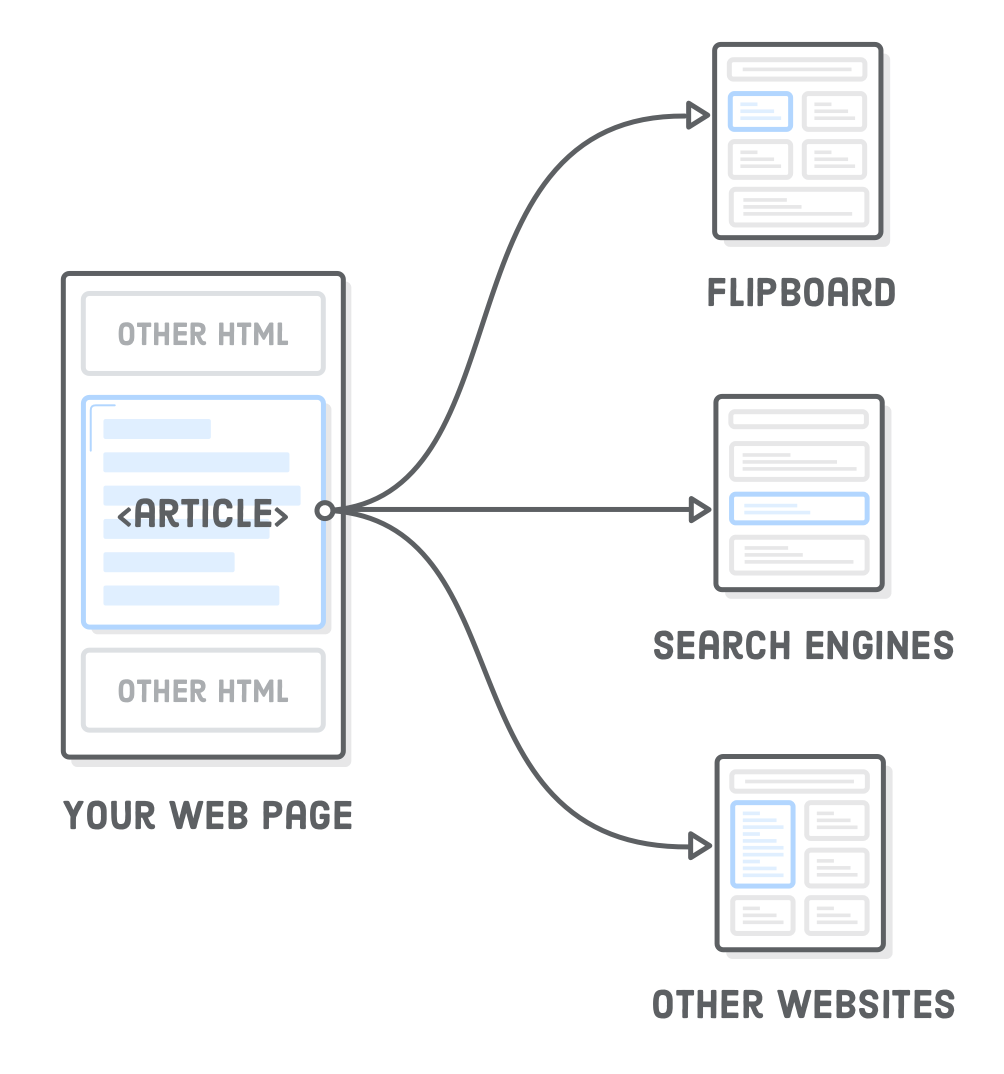
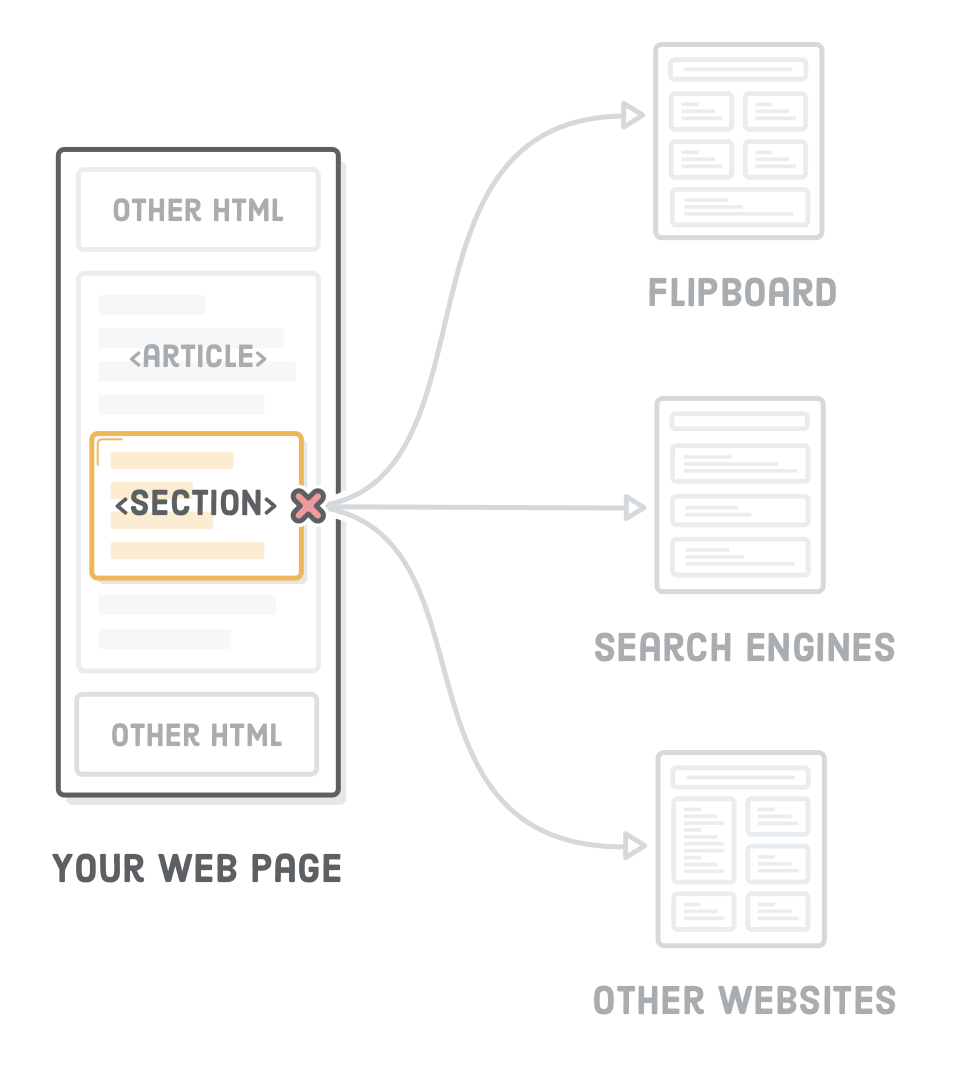
Les balises HTML <article> et <section> sont toutes deux utilisées pour structurer le contenu d'une page web, mais elles ont des significations et des usages légèrement différents.
La balise <article> est généralement utilisée pour marquer une partie autonome et auto-suffisante du contenu de la page.
Cela signifie qu'un <article> doit avoir un sens et une utilité indépendants, même s'il est retiré du contexte de la page.
Par exemple, un article de blog ou une publication de journal peut être encapsulé dans une balise <article>.
La balise <section> est utilisée pour diviser le contenu d'une page en sections thématiques ou logiques.
Elle est souvent utilisée pour organiser le contenu en chapitres ou en grandes parties.
Les éléments <section> permettent de structurer la page de manière à rendre le contenu plus lisible et compréhensible pour les utilisateurs, mais ils ne sont pas censés être des éléments autonomes comme <article>.

Nav, Header, Footer et Aside
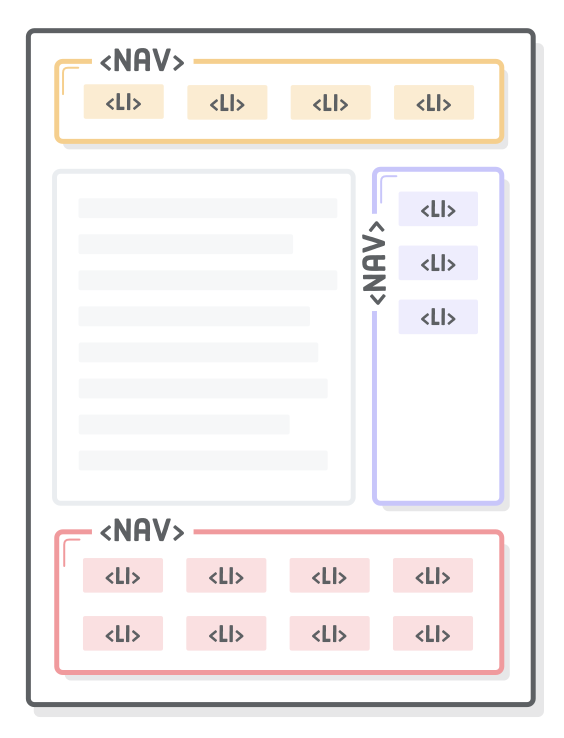
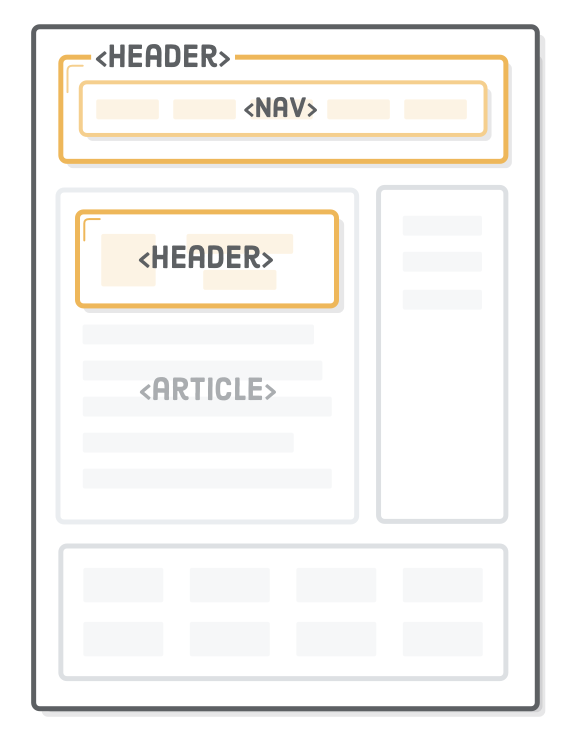
Les balises HTML <nav>, <header>, <footer> et <aside> sont toutes des éléments de structure utilisés pour organiser et définir la structure d'une page web.
La balise <nav> est utilisée pour marquer une section de la page qui contient des liens de navigation.
Cela peut inclure un menu principal, un menu secondaire, ou tout autre ensemble de liens facilitant la navigation sur le site.
La balise <header> est utilisée pour englober le contenu d'en-tête d'une section ou de la page entière.
Elle peut contenir des éléments tels que le logo du site, le titre principal ou les liens de navigation.
Le <header> est généralement positionné en haut de la page ou de la section.
La balise <footer> est utilisée pour marquer le contenu de bas de page d'une section ou de la page entière.
Elle contient généralement des informations comme les coordonnées, les liens vers les politiques du site, les mentions légales ou la date de copyright.
Le <footer> se trouve généralement en bas de la page ou de la section.
La balise <aside> est utilisée pour marquer le contenu lié de manière secondaire au contenu principal.
Cela peut inclure des encarts publicitaires, des informations connexes, ou des citations.
Les éléments <aside> sont souvent affichés à côté du contenu principal, mais ne sont pas essentiels à sa compréhension.

Source image | Source image | Source image | Source image
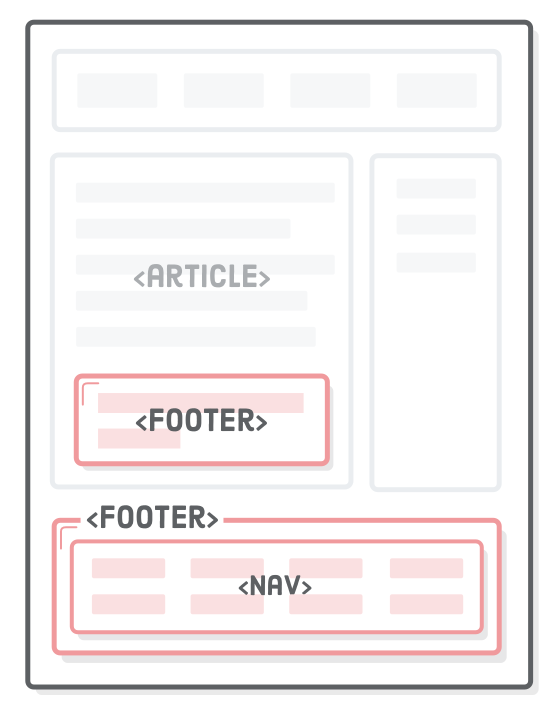
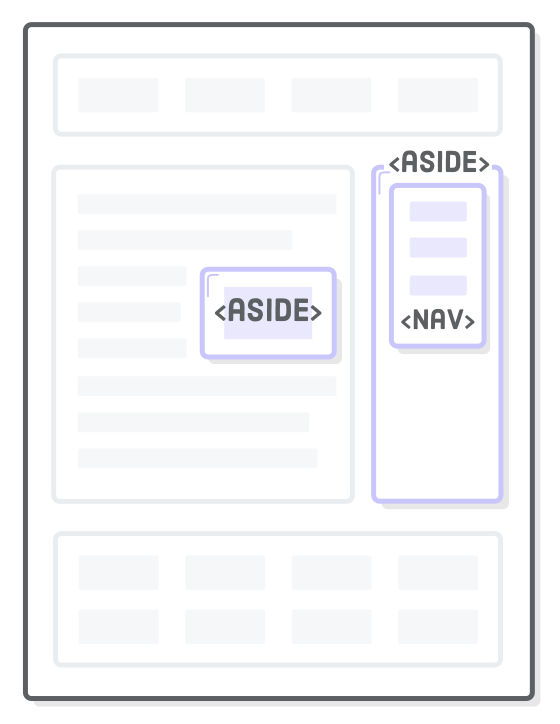
Source : WHATWG - HTML Standard (4.3 Sections)
Document outline
Le document outline en HTML fait référence à la structure logique d'un document, basée sur l'utilisation des éléments de titres (<h1> à <h6>).
Ces éléments servent à organiser et à définir clairement les différentes parties d'une page web.
Une structure logique des titres est essentielle pour les outils d'assistance (comme les lecteurs d'écran), car elle leur permet d'afficher la hiérarchie du contenu d'une page web, un peu comme une table des matières dans un document, un rapport ou un livre.
Le niveau d'un titre dépend uniquement de la balise utilisée (<h1> à <h6>), et non de sa position dans des éléments comme <section> ou <article>.
Info
Un ancien algorithme d'outline, qui calculait le niveau des titres d'après leur imbrication dans les sections, a été retiré du standard HTML en 2022 : il n'a jamais été pris en charge par les outils d'assistance.
✅ Exemple conforme
<body>
  <h1>Level 1</h1>
  <h2>Level 2</h2>
  <h3>Level 3</h3>
  <h1>Level 1</h1>
</body>


❌ Exemple non conforme
<body>
  <h1>Level 1</h1>
  <h3>Level 3</h3>
  <h2>Level 2</h2>
  <h1>Level 1</h1>
</body>


Cas particulier - H1
Dans ce cours, les titres de niveau 1 (<h1>) ne doivent pas être utilisés à l'intérieur d'éléments appartenant à la catégorie Sectioning Content, c'est-à-dire les balises qui définissent la structure d'un document : <article>, <aside>, <nav> et <section>.
Un <h1> placé dans une <section> reste un titre de niveau 1 : il casse la hiérarchie des titres.
✅ Exemple conforme
<body>
  <h1>Level 1</h1>
  <section>
    <h2>Level 2</h2>
  </section>
  <h3>Level 3</h3>
  <h1>Level 1</h1>
</body>
❌ Exemple non conforme
<body>
  <h1>Level 1</h1>
  <section>
    <h1>Level 1</h1>
  </section>
  <h2>Level 2</h2>
  <h1>Level 1</h1>
</body>


Info
Cette capture montre l'ancien rendu des navigateurs, qui affichaient un <h1> placé dans une <section> en plus petit.
Depuis 2025, ce style par défaut est retiré (Firefox 140, puis les autres navigateurs) : ce <h1> s'affiche en pleine taille.
La taille d'affichage d'un titre ne dit donc rien de son niveau.
Note
Le premier titre dans une page HTML doit toujours être un <h1>.
Même si c'est autorisé, n'utilisez pas plus d'un <h1> par page.
Ne sautez pas de niveau en descendant : un <h3> ne suit pas directement un <h1>. En remontant, on peut revenir à n'importe quel niveau supérieur (un <h1> après un <h3> est correct).
Ajoutez un titre à chaque élément <section> et <article>.
Sources :
- WHATWG - HTML Standard (4.3.11 Headings and outlines)
- MDN Web Docs -
<h1>–<h6>HTML section heading elements - MDN Web Docs - Default styles for h1 elements are changing (2025)
Lien utile
💡 En résumé : Réfléchir 》Coder 》Vérifier

DOM
Le DOM (Document Object Model) est une représentation hiérarchique de la structure d'une page HTML. Il s'agit d'une interface de programmation qui permet aux développeurs de manipuler dynamiquement le contenu et la structure d'une page web à l'aide de langages tels que JavaScript.
Sources :


Le DOM est fondamental pour les développeurs web, en particulier lors du développement et de l'utilisation des outils de développement intégrés dans les navigateurs modernes (Developer Tools).
Inspection des éléments
Les outils de développement permettent d'inspecter la structure du DOM en temps réel. Les développeurs peuvent visualiser la hiérarchie des éléments HTML, les propriétés CSS appliquées à chaque élément, ainsi que les valeurs de leurs attributs.
Modification en temps réel
Les outils de développement offrent la possibilité de modifier le contenu du DOM directement dans le navigateur. Il est possible de tester des changements de texte, d'attributs ou de styles sans altérer le code source du fichier HTML.
Debugging
Les développeurs peuvent s'appuyer sur le DOM pour diagnostiquer et corriger des problèmes dans une page web. Ils peuvent définir des points d'arrêt (breakpoints) dans le code JavaScript afin d'observer comment le DOM évolue lors de l'exécution du script.
