Git
Git est un système de gestion de versions décentralisé (Distributed Version Control System - DVCS) créé en 2005 par Linus Torvalds, le créateur du noyau Linux. Avant Git, le développement du noyau Linux reposait sur BitKeeper, un outil propriétaire. En 2005, à la suite d'un désaccord avec l'entreprise qui le développait, la communauté Linux a perdu le droit de l'utiliser gratuitement. Torvalds a alors conçu Git avec des objectifs clairs : vitesse, conception simple, gestion efficace de nombreuses branches en parallèle, fonctionnement entièrement décentralisé et capacité à gérer de très grands projets comme le noyau Linux.
Source : Git - Pro Git, A Short History of Git
Grâce à son efficacité et à sa robustesse, Git a rapidement été adopté par la communauté Linux, puis par l'ensemble du monde du développement logiciel. L'émergence de plateformes collaboratives comme GitHub, GitLab et Bitbucket a contribué à en faire la norme mondiale de gestion de versions.
Caractéristiques principales
- Décentralisation : Chaque développeur possède une copie locale complète du projet, incluant tout l'historique des versions.
- Intégrité : Tous les fichiers et commits sont identifiés par une empreinte (hash) SHA-1 calculée à partir de leur contenu. Si un contenu change, même d'un seul caractère, son empreinte change : Git détecte ainsi toute altération des données.
- Branches : Git facilite la création, la fusion et la gestion de branches pour permettre un développement parallèle fluide.
Exemples de plateformes utilisant Git
Ces services hébergent des dépôts Git et offrent des outils de collaboration, de revue de code et d'intégration continue.
Tip
Git est un outil incontournable pour les développeurs, les ingénieurs et plus largement pour tous les professionnels de l'informatique.
Il facilite la collaboration, le suivi des modifications et la gestion du code, des scripts et des configurations tout au long d'un projet.
Aujourd'hui, Git est au centre des processus d'automatisation : chaque modification validée peut lancer automatiquement une chaîne d'intégration continue comprenant les tests, la validation et le déploiement via les outils CI/CD.
Principe de fonctionnement
Git enregistre des instantanés (snapshots) complets des fichiers à chaque commit, plutôt que de ne stocker que les différences (diffs).
Cela rend les opérations (commits, comparaisons, retours en arrière) extrêmement rapides, tout en garantissant la cohérence de l'historique.
Les fichiers inchangés ne sont pas copiés à nouveau : le commit fait simplement référence à la version déjà stockée, ce qui économise l'espace disque.
Source : Git - Pro Git, What is Git?
Repository
Un repository (ou dépôt) est un espace de stockage qui conserve l'ensemble des fichiers et de leur historique.
Il permet de suivre, collaborer et gérer les modifications au fil du temps.
Fonctionnalités principales
- Historique complet : Chaque modification (commit) conserve l'auteur, la date et un message descriptif.
- Branches et fusion : Permet de développer de nouvelles fonctionnalités sans impacter la version principale.
- Collaboration : Plusieurs développeurs peuvent travailler simultanément et fusionner leurs contributions.
- Décentralisation : Chaque clone d'un dépôt Git contient l'historique complet du projet.
- Intégrité : Tous les objets Git sont identifiés par des empreintes SHA-1, ce qui permet de détecter toute altération.
SHA-1 et SHA-256
L'algorithme SHA-1 n'est plus considéré comme sûr : des attaques pratiques ont été démontrées. Git prend déjà en charge SHA-256 et prévoit d'en faire l'algorithme par défaut des nouveaux dépôts dans sa future version 3.0 (pas encore publiée, octobre 2026). Les dépôts existants en SHA-1 continueront de fonctionner.
Le plus gros projet utilisant Git
Le plus gros dépôt (repository) Git connu, en termes de taille, est probablement celui de Microsoft pour Windows. En 2017, Microsoft a annoncé avoir migré le code source de Windows vers Git.
Le dépôt de Windows est particulièrement massif :
- Environ 300 Go de données (pour comparaison, un clone complet du noyau Linux pèse environ 4.5 Go)
- Environ 3.5 millions de fichiers
- Environ 4 000 ingénieurs qui y contribuent quotidiennement
Source : Microsoft - The largest Git repo on the planet (Brian Harry, mai 2017, EN)
Composants d'un repository
Un repository Git se compose de trois zones principales :
Working Directory
- Contient les fichiers sur lesquels vous travaillez.
- Reflète une version donnée du projet.
Staging Area (index)
- Zone intermédiaire où les modifications sont préparées avant validation (commit).
Commit History (repository local)
- Base de données interne de Git qui stocke l'historique complet des commits.
- Chaque commit possède un identifiant unique (hash SHA-1) et un message associé.


Les métadonnées de Git sont stockées dans le dossier caché .git à la racine du projet.

Commit
Un commit représente un instantané du projet à un moment donné.
Il enregistre l'état complet des fichiers suivis au moment de la validation (et pas uniquement les différences).
Chaque commit contient :
- Un identifiant unique (hash SHA-1)
- Le nom et l'email de l'auteur
- La date et l'heure
- Un message descriptif du changement
- Une référence vers le commit précédent (son parent)
Grâce à cette référence vers le parent, les commits forment une chaîne chronologique qui permet de retracer l'évolution du projet.


Système décentralisé
Git est décentralisé par conception, mais souvent utilisé de façon centralisée.
Décentralisation native
- Chaque utilisateur possède une copie complète du dépôt, incluant tout l'historique.
- Les opérations (commits, merges, branches) peuvent être faites hors ligne.
- Chaque clone constitue une sauvegarde complète du projet.
Centralisation pratique
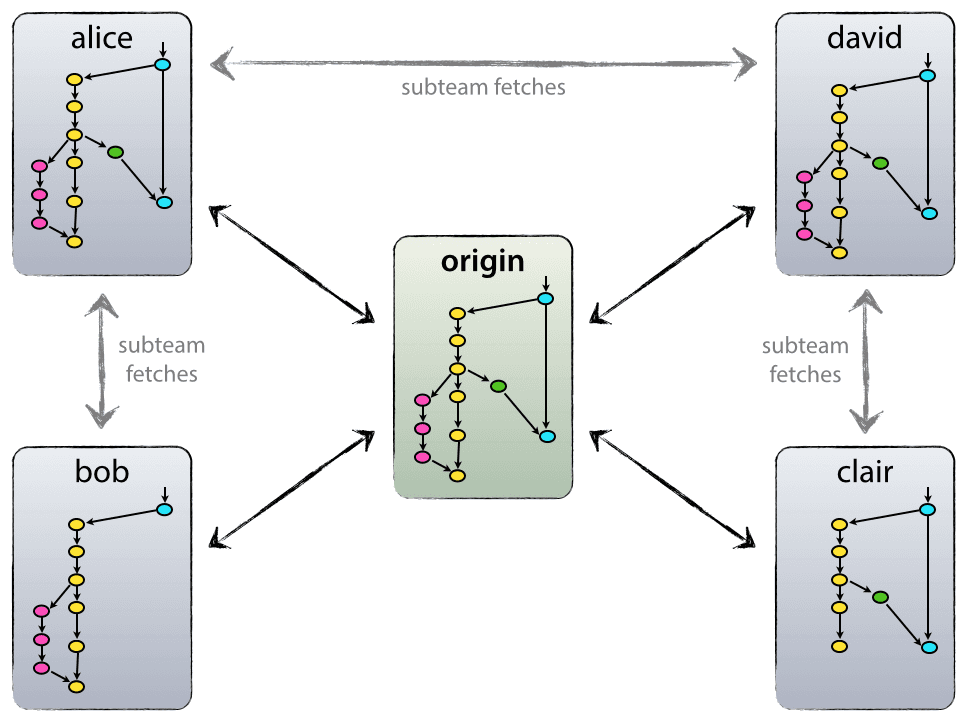
- Les plateformes comme GitHub ou GitLab servent de dépôt de référence (souvent appelé origin).
- Cela facilite la synchronisation et la collaboration en équipe.

Origin
Origin est le nom par défaut du repository distant d'où le projet a été cloné.


Commandes de base
| Commande | Description |
|---|---|
git clone <url> |
Clone un repository distant sur la machine locale |
git status |
Affiche l'état des fichiers (modifiés, indexés, non suivis) |
git add <fichier> |
Ajoute les modifications d'un fichier à la staging area (index) |
git commit -m "message" |
Crée un commit à partir du contenu de la staging area |
git push |
Envoie les commits locaux vers le repository distant |
git fetch |
Récupère les nouvelles données du repository distant sans les fusionner |
git pull |
Récupère et fusionne les modifications distantes |


Statuts des fichiers
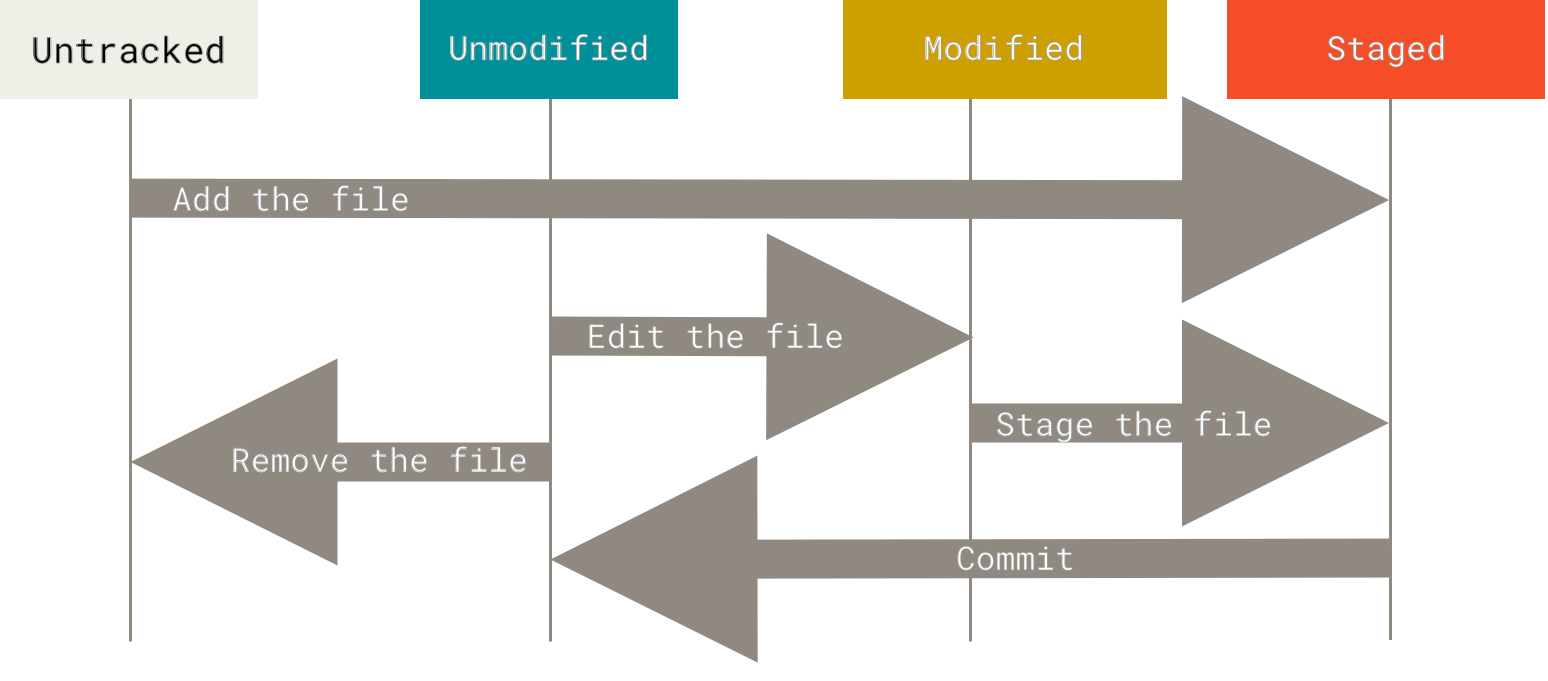
Les fichiers d'un projet peuvent se trouver dans différents états en fonction de leurs modifications et de leur position dans le workflow de Git.
| Statut | Description |
|---|---|
| Untracked | Fichiers non suivis par Git |
| Unmodified | Fichiers inchangés depuis le dernier commit |
| Modified | Fichiers modifiés mais non encore indexés |
| Staged | Fichiers ajoutés à l'index en attente de commit |
| Ignored | Fichiers explicitement exclus via .gitignore |

Message de commit
Un bon message de commit rend l'historique clair et compréhensible.
🚨 Les messages de commit s'écrivent en anglais !
✅ Bonnes pratiques
- Le titre du commit doit être concis (pas plus de 50 caractères) et décrire brièvement la modification principale.
- Le titre commence par une lettre majuscule.
- Pas de ponctuation à la fin du titre.
-
Le titre commence par un verbe d'action au mode impératif.
Add login page for user authenticationEcrivez le message comme s'il complétait la phrase « If applied, this commit will … »
-
Le titre est séparé du corps du message (body) par une ligne vide.
Add login page for user authentication

The username and password fields must not be empty or an error message
is displayed to the user.
Si vous fournissez un body (pour les commits plus détaillés), assurez-vous qu'il y a une ligne vide entre le titre et le body.
On utilise des phrases et donc la ponctuation dans le body. On peut aussi utiliser des listes.
-
Chaque ligne du body est limitée à maximum 72 caractères pour assurer une bonne lisibilité.
-
Pour les modifications plus complexes, le body est utilisé pour expliquer le "pourquoi" de la modification.
Le "quoi" est généralement décrit par le titre.
Le code (ou l'affichage des modifications) permet normalement de voir le "comment". Si ce n'est pas le cas, alors le code source devrait être commenté.
🚨 Chaque commit doit représenter un ensemble logique de changements. Cela rend les messages plus clairs et facilite la révision de l'historique du code.
Si vous avez besoin de plus de 50 caractères pour le titre du commit ou si vous avez de la peine à trouver un bon titre, cela signifie certainement que vous avez trop de changements dans votre commit et qu'il faut en faire plusieurs.
➡️ Git - Pro Git, Commit Guidelines
➡️ cbeams - How to Write a Git Commit Message
Fichier .gitignore
Le fichier .gitignore est un fichier spécial utilisé par Git pour exclure certains fichiers ou répertoires du suivi de version.
Autrement dit, les éléments listés dans ce fichier ne seront pas ajoutés à l'index de Git, même s'ils existent localement ou sont modifiés.
Warning
Le fichier .gitignore n'a aucun effet sur un fichier déjà suivi par Git (déjà commité). Pour arrêter de le suivre, il faut d'abord le retirer de l'index avec git rm --cached <file>, puis l'ajouter au .gitignore.
Un mot de passe déjà commité reste visible dans l'historique : il faut alors le changer.
Objectif
Le fichier .gitignore permet de garder le dépôt propre, sécurisé et pertinent, en excluant :
- Fichiers temporaires : créés automatiquement par le système d'exploitation ou l'IDE (ex. :
.DS_Store,Thumbs.db, fichiers de cache, logs, …). - Dépendances externes : qui peuvent être régénérées à partir de fichiers de configuration (ex. :
node_modules/,vendor/, …). - Fichiers sensibles : contenant des mots de passe, clés API ou configurations confidentielles (ex. :
.env, fichiers de configuration locaux contenant des secrets, …). - Fichiers de build : produits par la compilation ou l'exécution de scripts (
build/,dist/,target/,*.class,*.exe, …).
Syntaxe courante
| Expression | Signification |
|---|---|
* |
Correspond à n'importe quel nombre de caractères (sauf /) |
? |
Correspond à un seul caractère (sauf /) |
[abc] |
Correspond à un caractère parmi ceux listés |
**/ |
Au début d'un motif : correspond à n'importe quel dossier, à n'importe quel niveau de profondeur |
/ au début |
Limite la règle au dossier qui contient le .gitignore (souvent la racine du dépôt) |
/ à la fin |
Limite la règle aux dossiers (ex. logs/ ignore le dossier logs, mais pas un fichier logs) |
! |
Réintègre un fichier exclu par une règle précédente (ex. !important.log) |
# |
Indique un commentaire |
Exemple de fichier .gitignore
# Ignorer tous les fichiers .log
*.log

# Ignorer le dossier des dépendances pour Node.js
node_modules/

# Ignorer le fichier de configuration spécifique
# du dossier config à la racine du projet
/config/secret-config.yml
Workflow Git
Les workflows Git décrivent des méthodes et bonnes pratiques pour organiser le travail collaboratif dans un projet versionné avec Git.
Ils permettent aux équipes de travailler efficacement à plusieurs, de développer plusieurs fonctionnalités simultanément, et de préserver la stabilité du code à toutes les étapes du développement.
Note
Il existe d'autres workflows que ceux présentés ci-dessous, adaptés selon la taille des équipes, la fréquence des déploiements ou les outils CI/CD utilisés (ex. : Forking Workflow, Trunk-Based Development).
Centralized Workflow

- Tous les développeurs travaillent directement sur la branche principale (main).
- Simple à mettre en place, ce modèle est adapté aux petites équipes ou projets simples.
- Cependant, il devient vite difficile à maintenir lorsque plusieurs développeurs travaillent en parallèle, car les risques de conflits de code augmentent.
Feature Branch Workflow

- Chaque nouvelle fonctionnalité ou correction de bug est développée dans une branche dédiée (feature branch).
- Cela permet d'isoler les modifications, de tester avant la fusion et de préserver la stabilité de la branche principale.
- Les plateformes comme GitHub, GitLab ou Bitbucket favorisent ce workflow grâce aux pull requests (ou merge requests), qui permettent la revue de code avant intégration.


Gitflow Workflow

Le Gitflow Workflow, proposé par Vincent Driessen en 2010, définit un modèle structuré de gestion des branches adapté aux projets complexes.
Il repose sur deux branches principales :
- main : code de production stable (versions finales), appelée
masterdans l'article d'origine - develop : code en cours de développement
Des branches spécifiques et temporaires permettent de gérer les fonctionnalités, les corrections et les versions :
feature/…→ nouvelles fonctionnalitésrelease-…→ préparation d'une nouvelle versionhotfix-…→ corrections urgentes sur la version en production
Note
En 2020, Vincent Driessen a lui-même précisé que Gitflow convient surtout aux logiciels publiés en plusieurs versions numérotées, dont il faut parfois maintenir plusieurs versions en parallèle. Pour une application web livrée en continu (une seule version en production), il recommande un workflow plus simple, comme le Feature Branch Workflow (GitHub flow).
➡️ A successful Git branching model
Conventions de nommage des branches
| Type de branche | Exemple | Description |
|---|---|---|
| main | main |
Branche principale - code en production |
| develop | develop |
Branche de développement active |
| feature/<name> | feature/authentication |
Développement d'une nouvelle fonctionnalité |
| release-<version> | release-1.2.0 |
Préparation d'une nouvelle version stable |
| hotfix-<version> | hotfix-1.2.1 |
Correction urgente sur la version en production |
Numérotation des versions
La numérotation sémantique suit la convention MAJOR.MINOR.PATCH :
| Elément | Description |
|---|---|
| Major | Changements incompatibles avec les versions précédentes |
| Minor | Ajout de nouvelles fonctionnalités, compatibles avec les versions précédentes |
| Patch | Corrections de bugs (ou de sécurité), compatibles avec les versions précédentes |
Exemple : version 1.7.4
Merge et Rebase
Git propose plusieurs façons d'intégrer une branche dans une autre :
-
Merge Commit
- Lorsqu'une branche est fusionnée, Git crée un nouveau commit de fusion.
- L'historique reste non linéaire, montrant clairement quand et comment les branches ont été fusionnées.
- Utile pour préserver la traçabilité complète du développement.
- Inconvénient : l'historique peut devenir plus complexe à lire.
-
Rebase and Merge
- Le rebase « rejoue » les commits d'une branche sur une autre, recréant des commits équivalents.
- L'historique devient linéaire, ce qui le rend plus lisible.
- Cependant, le rebase modifie l'historique (nouveaux IDs de commit), ce qui peut poser problème si plusieurs personnes travaillent sur la même branche.
Note
Rebase and Merge est souvent utilisé pour obtenir un historique linéaire propre : après le rebase, la fusion se fait en fast-forward (avance rapide), c'est-à-dire que Git avance simplement la branche cible jusqu'au dernier commit, sans créer de commit de fusion.
Merge Commit (avec --no-ff) crée un commit explicite de fusion (no-fast-forward), même quand une avance rapide serait possible.
🚨 Gitflow recommande le Merge Commit pour toutes les fusions entre branches (feature → develop, release → main, etc.) afin de préserver la structure des branches.
Source : Vincent Driessen - A successful Git branching model (Incorporating a finished feature on develop)

